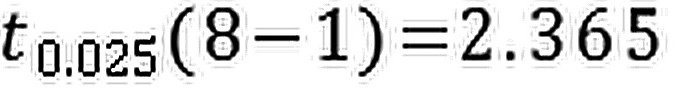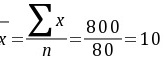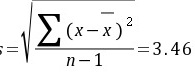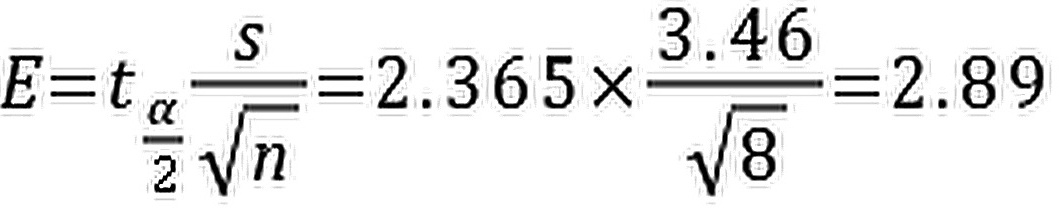logo
  • write-homewrite-home-active首页
  • icon-chaticon-chat-activeAI 智能助手
  • icon-pluginicon-plugin-active浏览器插件
  • icon-subjecticon-subject-active学科题目
  • icon-uploadicon-upload-active上传题库
  • 更多功能
  • icon-appicon-app-active手机APP
首页
/
统计
题目

从一个正态总体中随机抽取样本容量为8的样本,各样本值分别为:10,8,12,15,6,13,5,11。求总体均值95%的置信区间。(已知_(0.025)(8-1)=2.365-|||-__)。(10分)
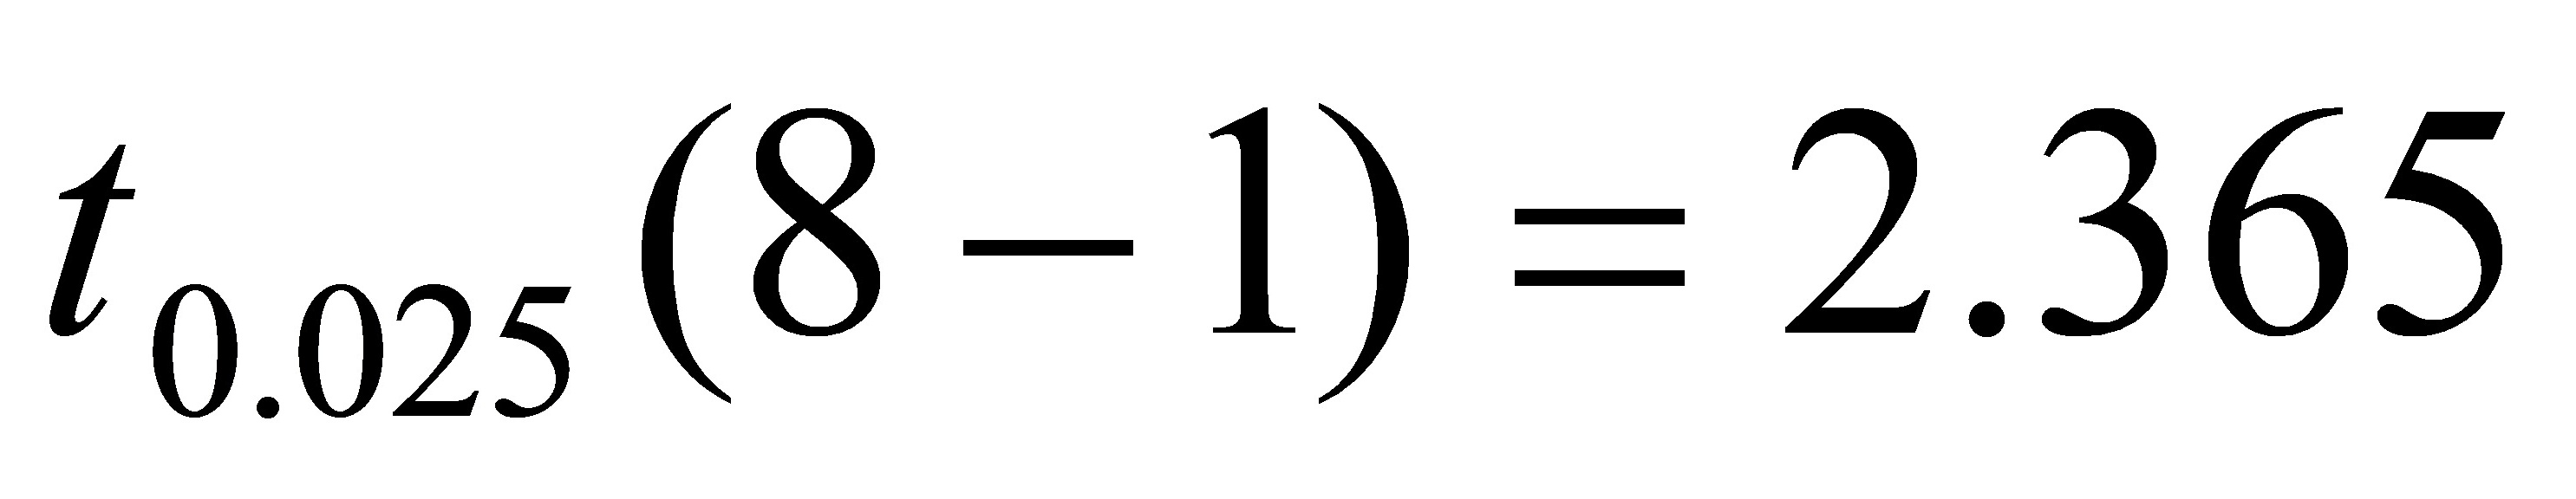
从一个正态总体中随机抽取样本容量为8的样本,各样本值分别为:10,8,12,15,6,13,5,11。求总体均值95%的置信区间。(已知)。(10分)

题目解答

答案

解:已知n=8,总体服从正态分布,未知,样本抽样分布服从t分布
置信下限=10-2.89=7.11
置信上限=10+2.89=12.89
总体均值的95%的置信区间为 [7.11,12.89]

解析

考查要点:本题主要考查小样本情况下正态总体均值的置信区间估计,涉及t分布的应用。

解题核心思路:

  1. 确定抽样分布:由于总体方差未知且样本容量小(n=8),样本均值的抽样分布服从t分布。
  2. 计算样本均值和样本标准差,这是置信区间的核心统计量。
  3. 查找t临界值:根据置信水平95%和自由度n-1=7,确定t临界值。
  4. 计算边缘误差,最终得到置信区间的上下限。

破题关键点:

  • 正确应用t分布公式,区分z分布与t分布的使用场景。
  • 准确计算样本均值和标准差,避免计算错误。
  • 自由度的确定(n-1),直接影响t临界值的选择。

1. 计算样本均值

样本均值公式为:
$\overline{x} = \frac{\sum x_i}{n} = \frac{10 + 8 + 12 + 15 + 6 + 13 + 5 + 11}{8} = \frac{80}{8} = 10$

2. 计算样本标准差

样本方差公式为:
$s^2 = \frac{\sum (x_i - \overline{x})^2}{n-1}$
计算各数据与均值的差的平方和:
$\begin{align*}(10-10)^2 &= 0, \\(8-10)^2 &= 4, \\(12-10)^2 &= 4, \\(15-10)^2 &= 25, \\(6-10)^2 &= 16, \\(13-10)^2 &= 9, \\(5-10)^2 &= 25, \\(11-10)^2 &= 1.\end{align*}$
平方和为 $0 + 4 + 4 + 25 + 16 + 9 + 25 + 1 = 84$,因此:
$s^2 = \frac{84}{8-1} = 12 \quad \Rightarrow \quad s = \sqrt{12} \approx 3.46$

3. 确定t临界值

已知自由度为 $n-1=7$,置信水平95%对应 $\alpha=0.05$,双尾检验下临界值为 $t_{0.025}(7) = 2.365$。

4. 计算边缘误差

边缘误差公式为:
$E = t_{\alpha/2} \cdot \frac{s}{\sqrt{n}} = 2.365 \cdot \frac{3.46}{\sqrt{8}} \approx 2.365 \cdot 1.223 \approx 2.89$

5. 确定置信区间

置信区间下限为 $\overline{x} - E = 10 - 2.89 = 7.11$,上限为 $\overline{x} + E = 10 + 2.89 = 12.89$。

相关问题

  • 在房价预估中,哪种模型最常被用于回归预测?A. 线性回归B. 决策树C. K近邻D. 朴素贝叶斯

  • {15分)常规情况下,下列不属于人口学变量的是A. 民族B. 收入C. 年龄D. 睡眠时间E. 性别

  • 44.2021年,我国人均预期寿命提高到了()。A. 78岁B. 79岁C. 78.2岁D. 79.2岁

  • 下列哪项属于常见的池化方式。()A. 反向传播B. 最大池化C. 方差池化D. 协方差池化

  • 可以从最小化每个类簇的方差这一视角来解释K均值聚类的结果,下面对这一视角描述正确的A. 每个样本数据分别归属于与其距离最远的聚类质心所在聚类集合B. 每个簇类的质心累加起来最小C. 最终聚类结果中每个聚类集合中所包含数据呈现出来差异性最大D. 每个簇类的方差累加起来最小

  • 假定用于分析的数据包含属性age.数据元组[1]中age的值如下(按递增序):13,15,16,16,19,20,20,21,22,22,25,25,25,30,33,33,35,35,36,40,45,46,52,70, 问题:使用按箱平均值平滑方法对上述数据进行平滑,箱的深度为3。第二个箱子值为:A. 18.3B. 22。6C. 26。8D. 27。9

  • 下列关于回归分析的描述不正确的是()A. 回归分析模型可分为线性回归模型和非线性回归模型B. 回归分析研究不同变量之间存在的关系()C. 刻画不同变量之间关系的模型统称为线性回归模型D. 回归分析研究单个变量的变化情况

  • 以下几种数据挖掘功能中,〔〕被广泛的用于购物篮分析.A. 关联分析B. 分类和预测C. 聚类分析D. 演变分析

  • 下列说法正确的是()A. 方差数值上等于各个数据与样本方差之差的平方和之平均数B. 协方差和方差的计算方式完全一致C. 协方差衡量了多个变量的分布D. 方差描述了样本数据的波动程度

  • 2024年,我国每天大约有( )个小包裹往来于中国和世界各国之间A. 800万B. 1100万C. 1000万D. 900万

  • 皮尔逊相关系数的取值范围为0到正无穷。()A. 正确B. 错误

  • 对研究对象制定明确的纳入标准和排除标准,是为了保证样本的A. 可靠性B. 可行性C. 代表性D. 合理性E. 科学性

  • 下列说法正确的是()A. 方差数值上等于各个数据与样本方差之差的平方和之平均数B. 协方差衡量了多个变量的分布C. 协方差和方差的计算方式完全一致D. 方差描述了样本数据的波动程度

  • 重测信度用重测相关系数来表示,相关系数越趋近于下列哪一数值时,则重测信度越高A. 1B. 0.7C. 2D. 3

  • 48皮尔逊相关系数的取值范围为0到正无穷。()A. 错误B. 正确

  • 请你从下表中找出1~100中所有质数.并数一数一共多少个. 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100

  • 像从性不好的资料是()A. 由于死亡或者其他原因不能继续试验B. 能按照试验规定要求完成实验C. 重复参加试验D. 由于纳入标准不合格导致选择的研究对象不符合试验要求E. 能完成试验但是不能按照规定要求完成试验

  • 下列哪项属于常见的池化方式。()A. 协方差池化B. 方差池化C. 反向传播D. 最大池化

上一页下一页
logo
广州极目未来文化科技有限公司
注册地址:广州市黄埔区揽月路8号135、136、137、138房
关于
  • 隐私政策
  • 服务协议
  • 权限详情
学科
  • 医学
  • 政治学
  • 管理
  • 计算机
  • 教育
  • 数学
联系我们
  • 客服电话: 010-82893100
  • 公司邮箱: daxuesoutijiang@163.com
  • qt

©2023 广州极目未来文化科技有限公司 粤ICP备2023029972号    粤公网安备44011202002296号