题目
设变量UND 1,λ2,△3的相关阵为UND 1,λ2,△3的特征值和单位化特征向量分别为(1)取公共因子个数为2,求因子载荷阵UND 1,λ2,△3。(2)计算变量共同度UND 1,λ2,△3及公共因子UND 1,λ2,△3的方差贡献,并说明其统计意义。
设变量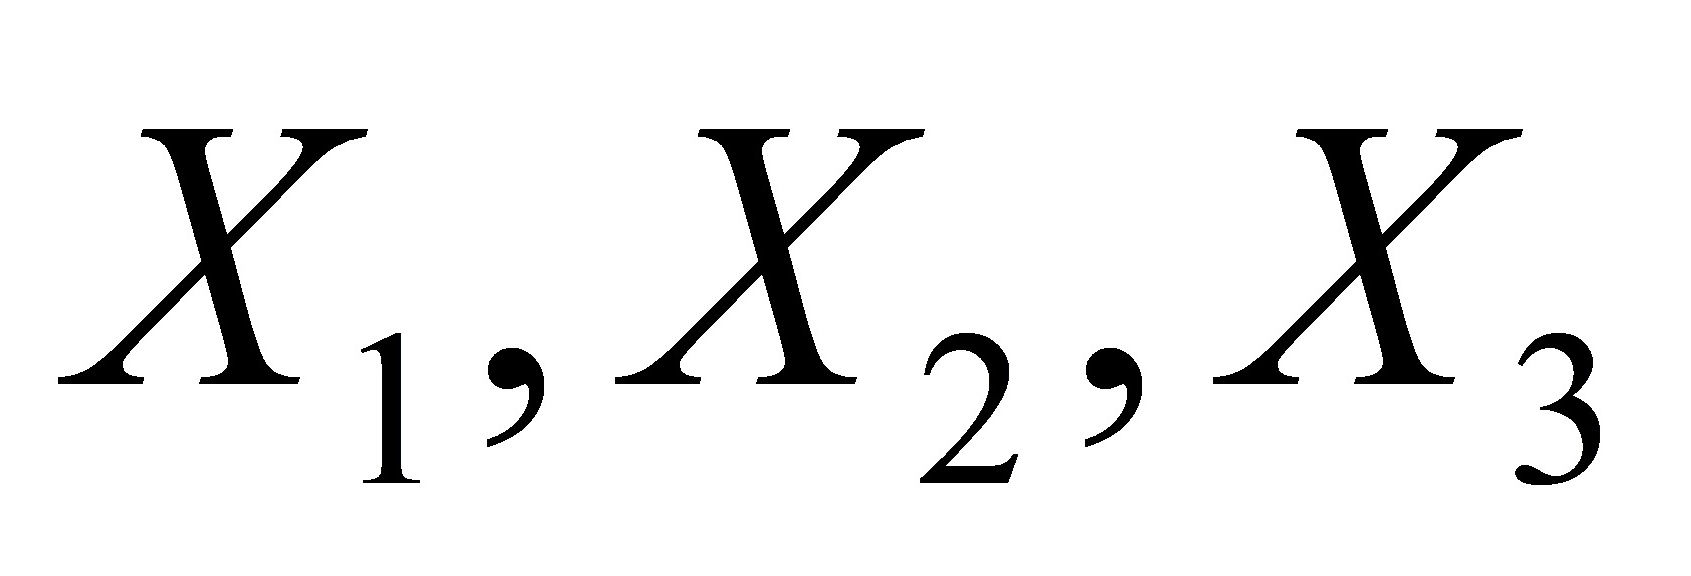 的相关阵为
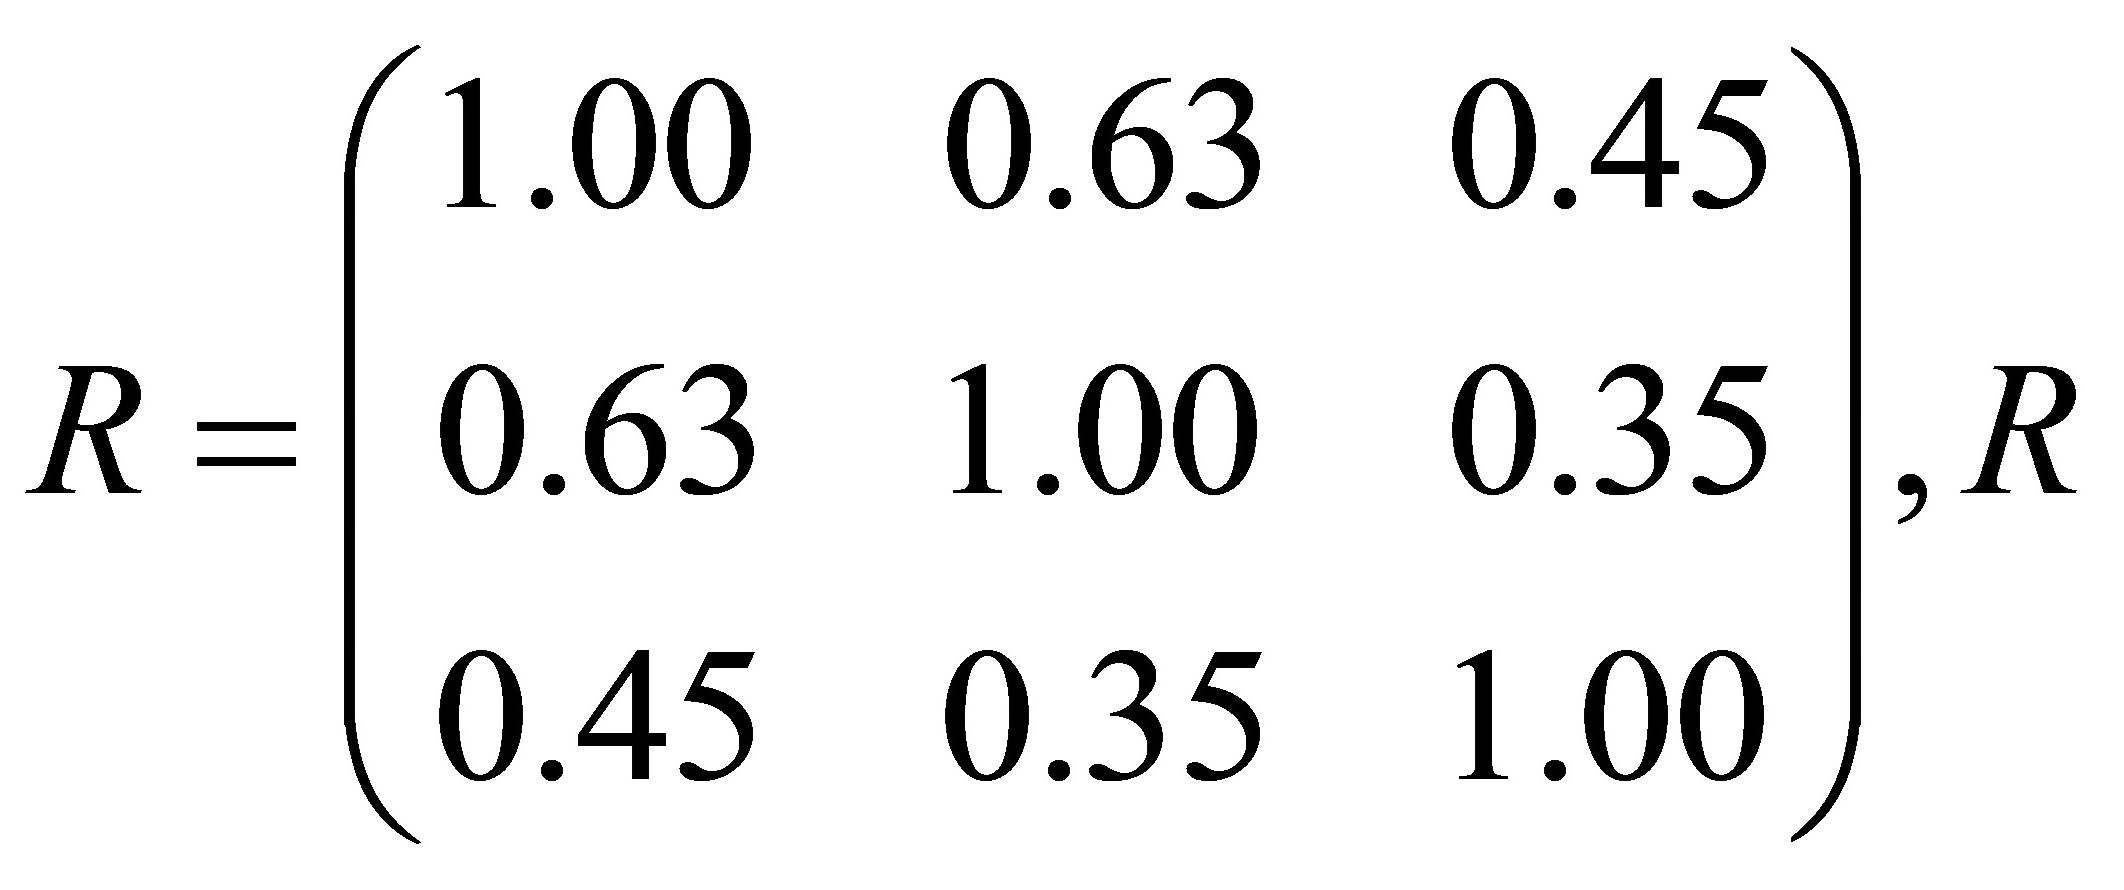 的特征值和单位化特征向量分别为
(1)取公共因子个数为2,求因子载荷阵 。
(2)计算变量共同度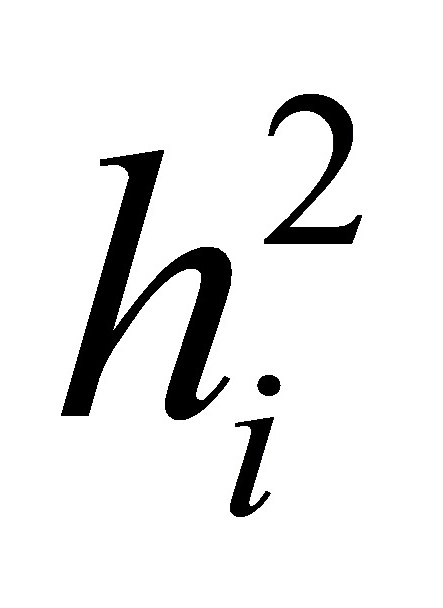 及公共因子
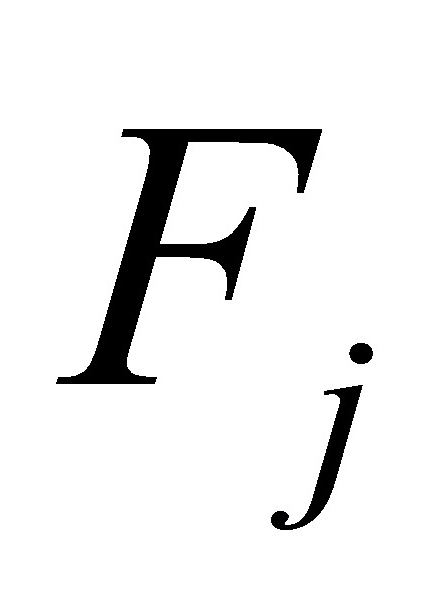 的方差贡献,并说明其统计意义。
题目解答
答案
解:因子载荷阵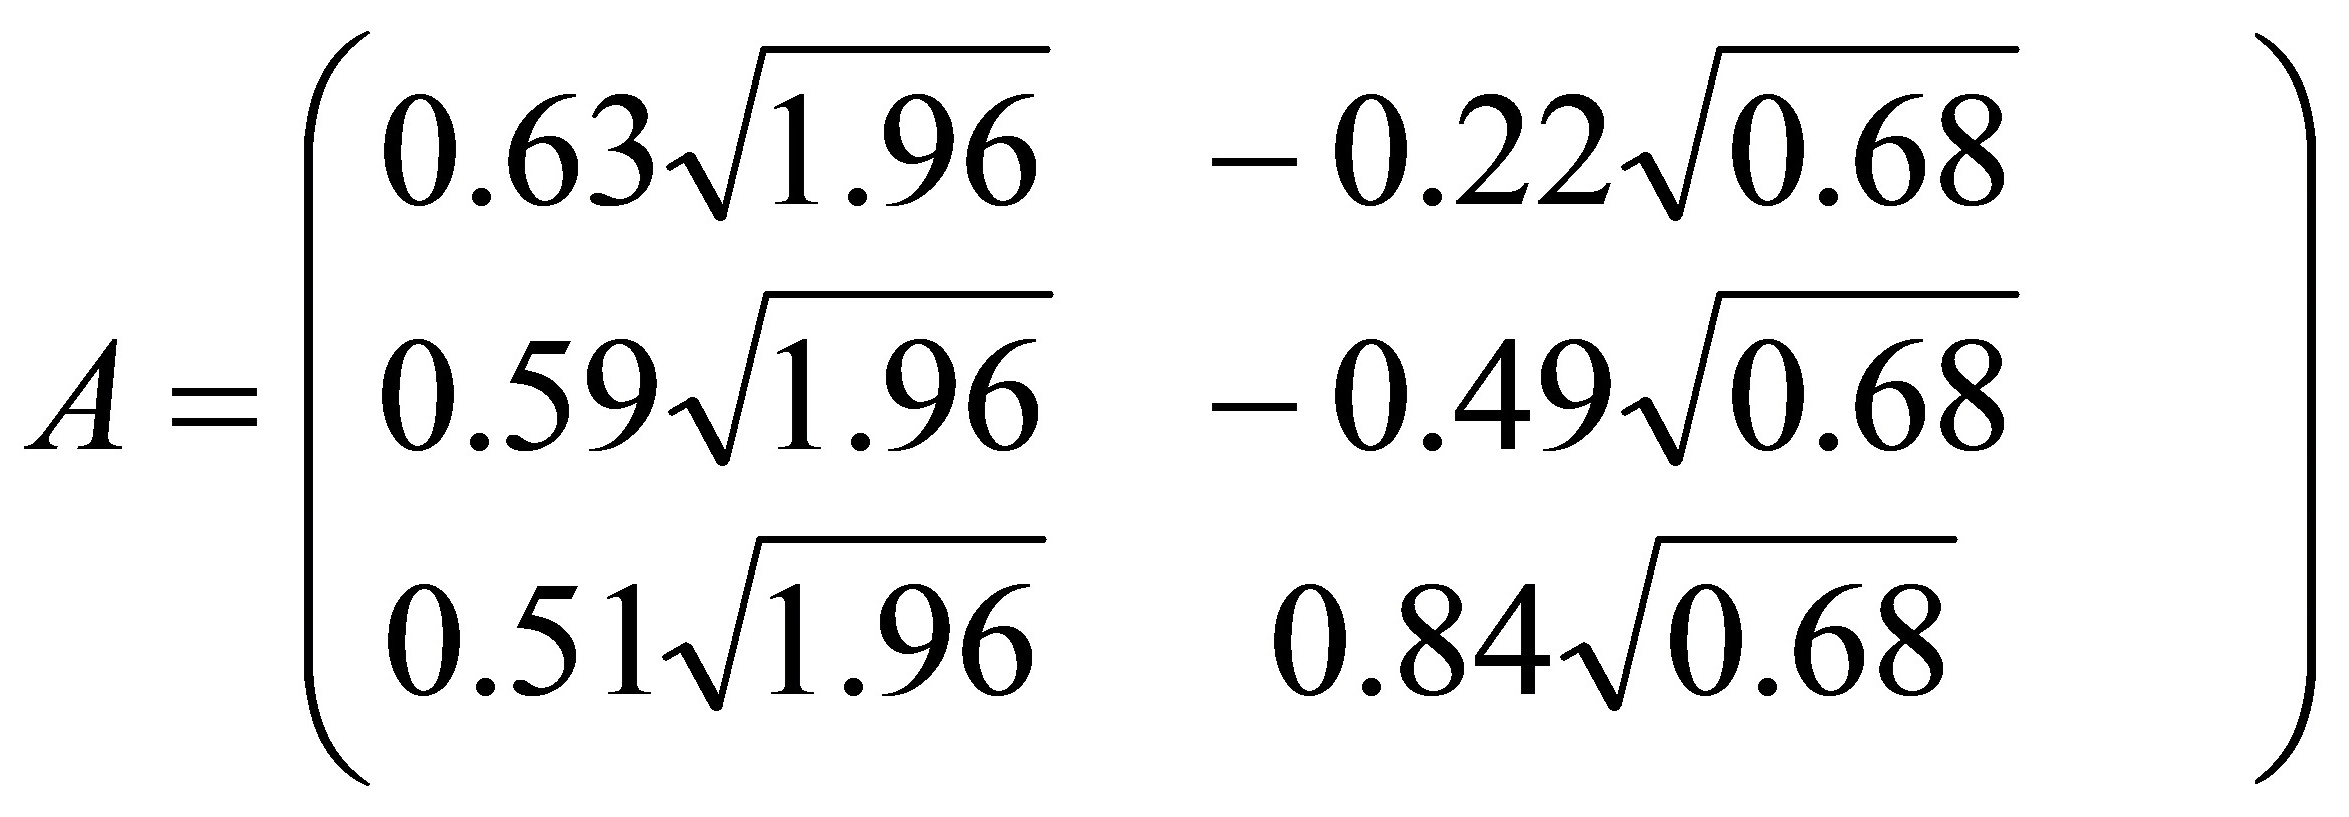
变量共同度: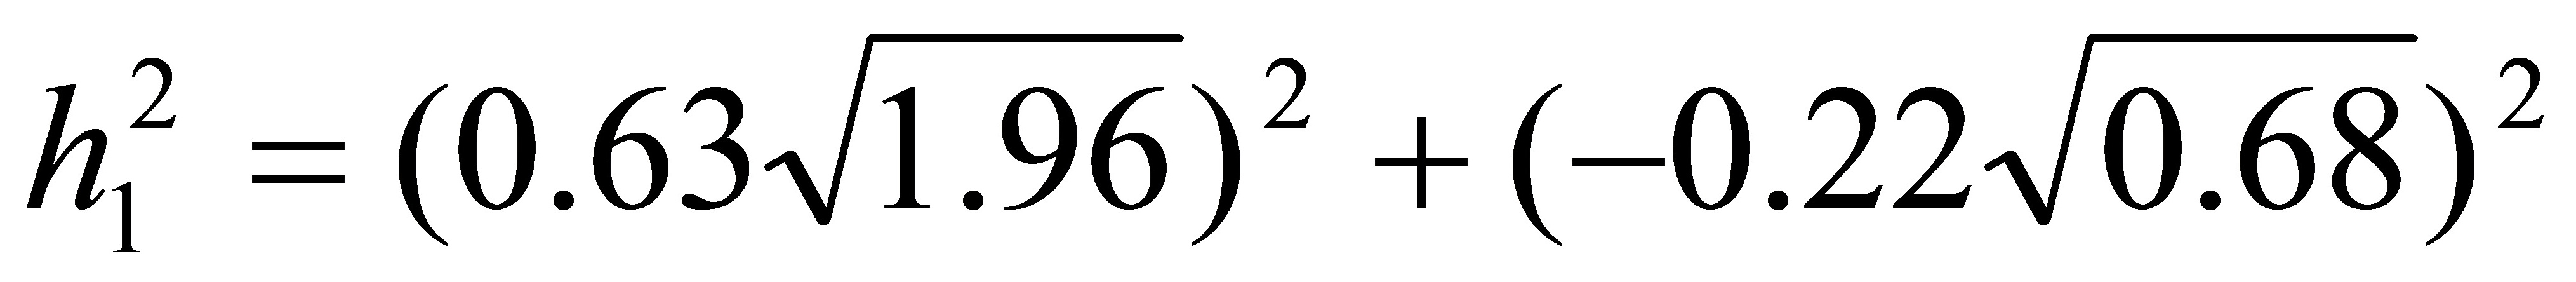 =
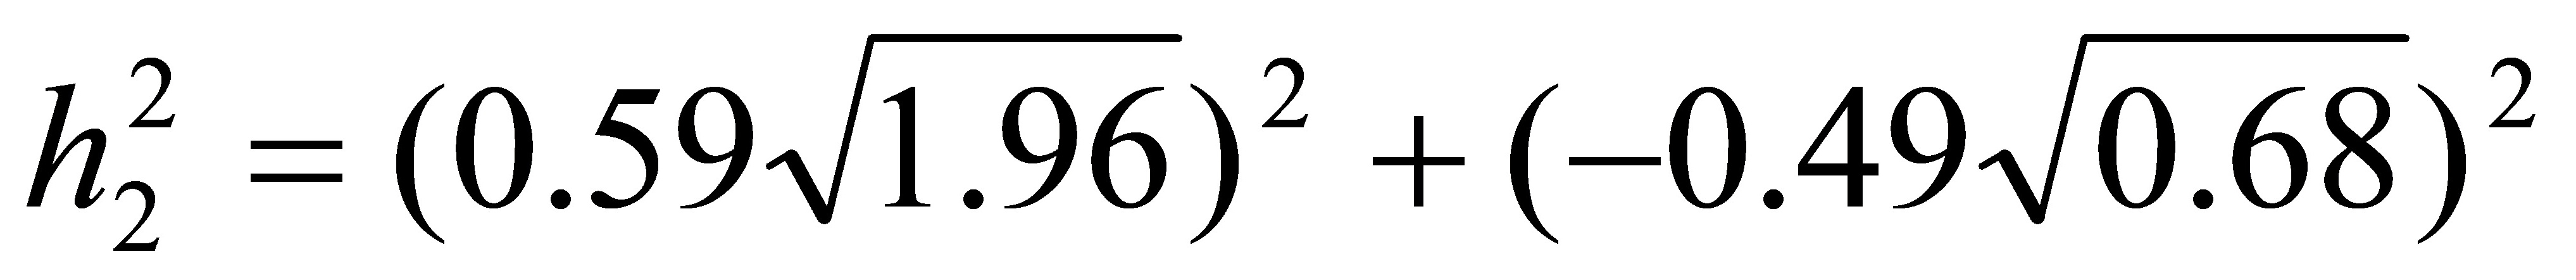 =
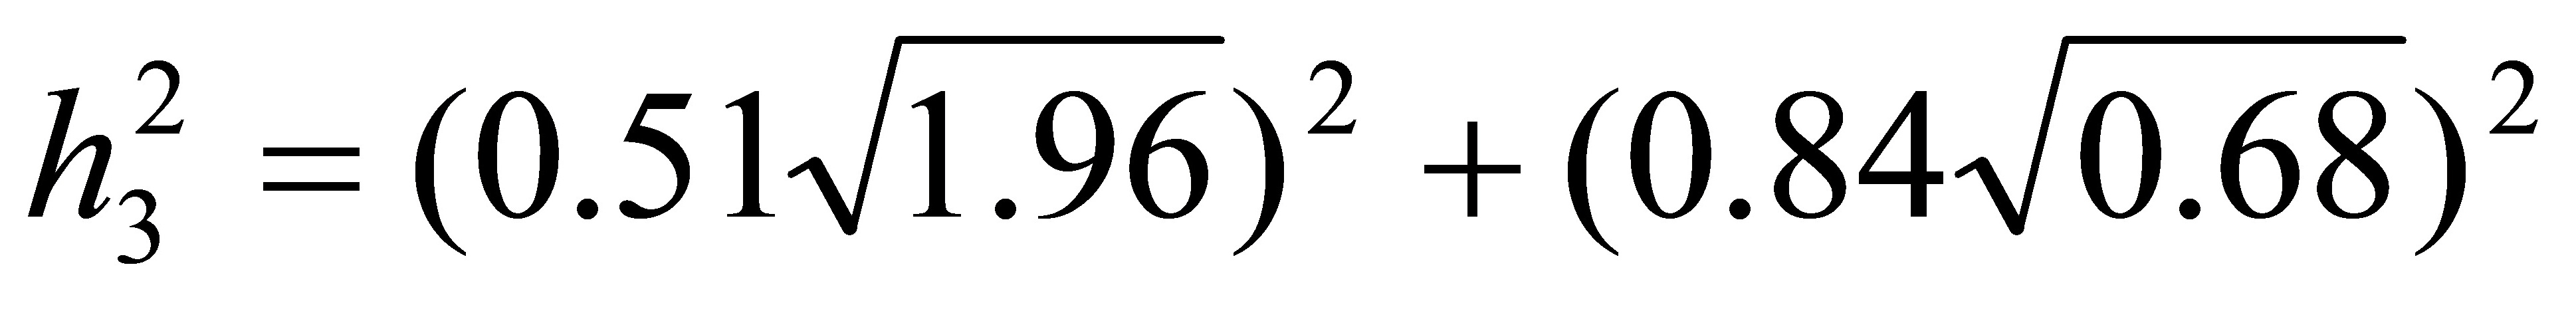 =
公共因子的方差贡献:
统计意义(略)
解析
步骤 1:计算特征值和特征向量
首先,我们需要计算相关矩阵R的特征值和特征向量。相关矩阵R为:
$$
R = \begin{pmatrix}
1.00 & 0.63 & 0.45 \\
0.63 & 1.00 & 0.35 \\
0.45 & 0.35 & 1.00
\end{pmatrix}
$$
通过计算,我们得到特征值和对应的单位化特征向量:
特征值:$\lambda_1 = 1.96$,$\lambda_2 = 0.68$,$\lambda_3 = 0.36$
单位化特征向量:$v_1 = \begin{pmatrix} 0.63 \\ 0.59 \\ 0.51 \end{pmatrix}$,$v_2 = \begin{pmatrix} -0.22 \\ -0.49 \\ 0.84 \end{pmatrix}$,$v_3 = \begin{pmatrix} 0.76 \\ -0.64 \\ -0.12 \end{pmatrix}$
步骤 2:构造因子载荷阵
根据特征值和特征向量,我们可以构造因子载荷阵A。因子载荷阵A的元素为特征向量的元素乘以对应特征值的平方根。由于我们只取前两个公共因子,因此因子载荷阵A为:
$$
A = \begin{pmatrix}
0.63\sqrt{1.96} & -0.22\sqrt{0.68} \\
0.59\sqrt{1.96} & -0.49\sqrt{0.68} \\
0.51\sqrt{1.96} & 0.84\sqrt{0.68}
\end{pmatrix}
$$
步骤 3:计算变量共同度和公共因子的方差贡献
变量共同度$h_i^2$为因子载荷阵A中第i行元素的平方和。公共因子的方差贡献为特征值除以变量个数(这里是3)。
$$
h_1^2 = (0.63\sqrt{1.96})^2 + (-0.22\sqrt{0.68})^2
$$
$$
h_2^2 = (0.59\sqrt{1.96})^2 + (-0.49\sqrt{0.68})^2
$$
$$
h_3^2 = (0.51\sqrt{1.96})^2 + (0.84\sqrt{0.68})^2
$$
公共因子的方差贡献:
$$
\text{因子1的方差贡献} = \frac{1.96}{3}
$$
$$
\text{因子2的方差贡献} = \frac{0.68}{3}
$$
首先,我们需要计算相关矩阵R的特征值和特征向量。相关矩阵R为:
$$
R = \begin{pmatrix}
1.00 & 0.63 & 0.45 \\
0.63 & 1.00 & 0.35 \\
0.45 & 0.35 & 1.00
\end{pmatrix}
$$
通过计算,我们得到特征值和对应的单位化特征向量:
特征值:$\lambda_1 = 1.96$,$\lambda_2 = 0.68$,$\lambda_3 = 0.36$
单位化特征向量:$v_1 = \begin{pmatrix} 0.63 \\ 0.59 \\ 0.51 \end{pmatrix}$,$v_2 = \begin{pmatrix} -0.22 \\ -0.49 \\ 0.84 \end{pmatrix}$,$v_3 = \begin{pmatrix} 0.76 \\ -0.64 \\ -0.12 \end{pmatrix}$
步骤 2:构造因子载荷阵
根据特征值和特征向量,我们可以构造因子载荷阵A。因子载荷阵A的元素为特征向量的元素乘以对应特征值的平方根。由于我们只取前两个公共因子,因此因子载荷阵A为:
$$
A = \begin{pmatrix}
0.63\sqrt{1.96} & -0.22\sqrt{0.68} \\
0.59\sqrt{1.96} & -0.49\sqrt{0.68} \\
0.51\sqrt{1.96} & 0.84\sqrt{0.68}
\end{pmatrix}
$$
步骤 3:计算变量共同度和公共因子的方差贡献
变量共同度$h_i^2$为因子载荷阵A中第i行元素的平方和。公共因子的方差贡献为特征值除以变量个数(这里是3)。
$$
h_1^2 = (0.63\sqrt{1.96})^2 + (-0.22\sqrt{0.68})^2
$$
$$
h_2^2 = (0.59\sqrt{1.96})^2 + (-0.49\sqrt{0.68})^2
$$
$$
h_3^2 = (0.51\sqrt{1.96})^2 + (0.84\sqrt{0.68})^2
$$
公共因子的方差贡献:
$$
\text{因子1的方差贡献} = \frac{1.96}{3}
$$
$$
\text{因子2的方差贡献} = \frac{0.68}{3}
$$