题目
对某地区171 980户居民家庭收入进行调查,以居民户为抽样单位,根据城镇和乡村将居民划为2层,每层按简单随机抽样抽取300户,经整理得如下数据:层城镇23560151800.1372972乡村14842098560.8632546试根据此估计:(20分)(1)居民平均收入及其95%的置信区间.(2)若是按比例分配和奈曼分配时,各层样本量分别应为多少?
对某地区171 980户居民家庭收入进行调查,以居民户为抽样单位,根据城镇和乡村将居民划为2层,每层按简单随机抽样抽取300户,经整理得如下数据:
层 | ||||
城镇 | 23560 | 15180 | 0.137 | 2972 |
乡村 | 148420 | 9856 | 0.863 | 2546 |
试根据此估计:(20分)
(1)居民平均收入及其95%的置信区间.
(2)若是按比例分配和奈曼分配时,各层样本量分别应为多少?
题目解答
答案
(1)(10分)
由题中相关数据资料: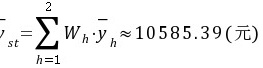 (3分)
(3分)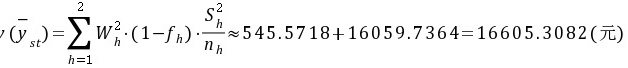 (3分)
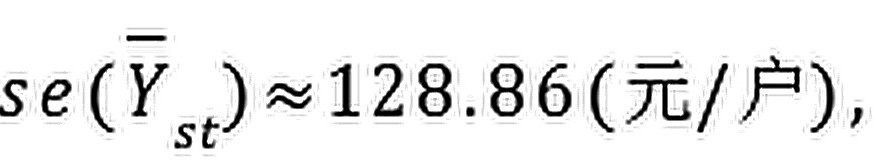
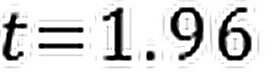 (2分)
该地区居民平均收入的95%的置信区间为:
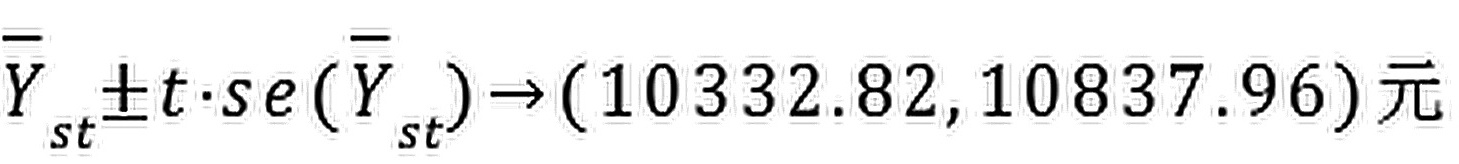 (2分)
(2)(10分)
按比例分配:
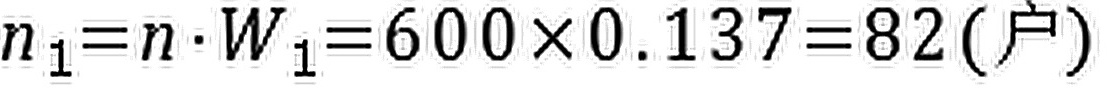 (2分)
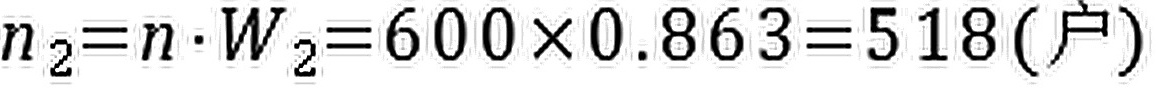 (2分)
按奈曼分配:
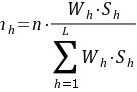
由表中资料: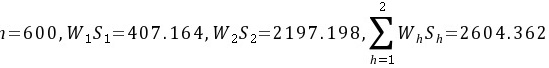
由上可得根据奈曼分配,各层所需样本容量为:
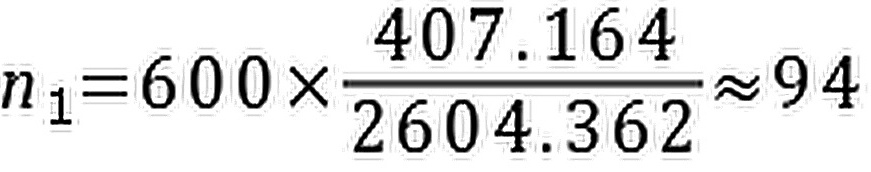 (3分)
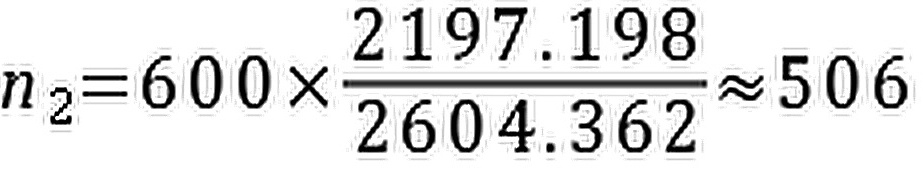 (3分)
解析
步骤 1:计算加权平均收入
根据题目中提供的数据,我们首先计算城镇和乡村居民的加权平均收入。城镇居民的平均收入为23560元,乡村居民的平均收入为148420元,城镇居民占总居民的比例为0.137,乡村居民占总居民的比例为0.863。因此,加权平均收入为:
${T}_{st}=\sum _{h=1}^{2}{w}_{h}\cdot \overline {{y}_{h}}=0.137\times 23560+0.863\times 148420\approx 10585.39$ (元)
步骤 2:计算标准误
根据题目中提供的数据,我们计算城镇和乡村居民的收入标准差,城镇居民的收入标准差为2972元,乡村居民的收入标准差为2546元。因此,标准误为:
$se(\overline {Y}st)=\sqrt {\sum _{h=1}^{2}{w}_{h}^{2}\cdot \dfrac {{S}_{h}^{2}}{n_{h}}}\approx \sqrt {0.137^{2}\times \dfrac {2972^{2}}{300}+0.863^{2}\times \dfrac {2546^{2}}{300}}\approx 128.86$ (元/户)
步骤 3:计算95%置信区间
根据标准误和t分布的临界值,我们计算95%置信区间。t分布的临界值为1.96,因此,95%置信区间为:
$\overline {Y}_{s}ttse(\overline {Y}st)\rightarrow (10585.39-1.96\times 128.86,10585.39+1.96\times 128.86)\rightarrow (10332.82,10837.96)$ (元)
步骤 4:按比例分配计算样本量
根据题目中提供的数据,我们计算城镇和乡村居民的样本量。城镇居民占总居民的比例为0.137,乡村居民占总居民的比例为0.863,总样本量为600户。因此,城镇和乡村居民的样本量分别为:
${n}_{1}=n\cdot {W}_{1}=600\times 0.137=82$ (户)
${n}_{2}=n\cdot {W}_{2}=600\times 0.863=518$ (户)
步骤 5:按奈曼分配计算样本量
根据题目中提供的数据,我们计算城镇和乡村居民的样本量。城镇居民的收入标准差为2972元,乡村居民的收入标准差为2546元,城镇居民占总居民的比例为0.137,乡村居民占总居民的比例为0.863,总样本量为600户。因此,城镇和乡村居民的样本量分别为:
${n}_{1}=600\times \dfrac {0.137\times 2972}{0.137\times 2972+0.863\times 2546}\approx 94$ (户)
${n}_{2}=600\times \dfrac {0.863\times 2546}{0.137\times 2972+0.863\times 2546}\approx 506$ (户)
根据题目中提供的数据,我们首先计算城镇和乡村居民的加权平均收入。城镇居民的平均收入为23560元,乡村居民的平均收入为148420元,城镇居民占总居民的比例为0.137,乡村居民占总居民的比例为0.863。因此,加权平均收入为:
${T}_{st}=\sum _{h=1}^{2}{w}_{h}\cdot \overline {{y}_{h}}=0.137\times 23560+0.863\times 148420\approx 10585.39$ (元)
步骤 2:计算标准误
根据题目中提供的数据,我们计算城镇和乡村居民的收入标准差,城镇居民的收入标准差为2972元,乡村居民的收入标准差为2546元。因此,标准误为:
$se(\overline {Y}st)=\sqrt {\sum _{h=1}^{2}{w}_{h}^{2}\cdot \dfrac {{S}_{h}^{2}}{n_{h}}}\approx \sqrt {0.137^{2}\times \dfrac {2972^{2}}{300}+0.863^{2}\times \dfrac {2546^{2}}{300}}\approx 128.86$ (元/户)
步骤 3:计算95%置信区间
根据标准误和t分布的临界值,我们计算95%置信区间。t分布的临界值为1.96,因此,95%置信区间为:
$\overline {Y}_{s}ttse(\overline {Y}st)\rightarrow (10585.39-1.96\times 128.86,10585.39+1.96\times 128.86)\rightarrow (10332.82,10837.96)$ (元)
步骤 4:按比例分配计算样本量
根据题目中提供的数据,我们计算城镇和乡村居民的样本量。城镇居民占总居民的比例为0.137,乡村居民占总居民的比例为0.863,总样本量为600户。因此,城镇和乡村居民的样本量分别为:
${n}_{1}=n\cdot {W}_{1}=600\times 0.137=82$ (户)
${n}_{2}=n\cdot {W}_{2}=600\times 0.863=518$ (户)
步骤 5:按奈曼分配计算样本量
根据题目中提供的数据,我们计算城镇和乡村居民的样本量。城镇居民的收入标准差为2972元,乡村居民的收入标准差为2546元,城镇居民占总居民的比例为0.137,乡村居民占总居民的比例为0.863,总样本量为600户。因此,城镇和乡村居民的样本量分别为:
${n}_{1}=600\times \dfrac {0.137\times 2972}{0.137\times 2972+0.863\times 2546}\approx 94$ (户)
${n}_{2}=600\times \dfrac {0.863\times 2546}{0.137\times 2972+0.863\times 2546}\approx 506$ (户)