logo
  • write-homewrite-home-active首页
  • icon-chaticon-chat-activeAI 智能助手
  • icon-pluginicon-plugin-active浏览器插件
  • icon-subjecticon-subject-active学科题目
  • icon-uploadicon-upload-active上传题库
  • 更多功能
  • icon-appicon-app-active手机APP
首页
/
统计
题目

用一组有30个观测值的样本估计模型_(i)=(P)_(0)+(beta )_(1)(X)_(11)+(P)_(2)(X)_(2i)+(beta )_(3)(X)_(3i)+(mu )_(i),并在0.05的显著性水平下对总体显著性进行检验,则检验拒绝零假设的条件是统计量F大于( )。A. F0.05(3,26) B. t0.025(3,30) C. F0.05(3,30) D. t0.025(2,26)

用一组有30个观测值的样本估计模型,并在0.05的显著性水平下对总体显著性进行检验,则检验拒绝零假设的条件是统计量F大于(      )。
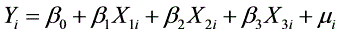
A.  F0.05(3,26)      
B. t0.025(3,30)        
C.  F0.05(3,30)  
D.  t0.025(2,26)

题目解答

答案

A. F0.05(3,26)

解析

本题考查多元线性回归模型总体显著性检验中F统计量的临界值确定,解题的关键在于明确F统计量的自由度以及显著性水平,然后根据这些信息确定拒绝零假设的条件。

  1. 确定F检验的原理:
    在多元线性回归模型$Y_{i}=\beta_{0}+\beta_{1}X_{1i}+\beta_{2}X_{2i}+\beta_{3}X_{3i}+\mu_{i}$的总体显著性检验中,原假设$H_{0}:\beta_{1}=\beta_{2}=\beta_{3}=0$,备择假设$H_{1}:\beta_{j}$不全为$0$,$j = 1,2,3$。我们使用F统计量来进行检验,F统计量服从F分布。
  2. 计算F统计量的自由度:
    • 分子自由度$k$:在多元线性回归模型中,分子自由度等于解释变量的个数。本题中有$X_{1i}$、$X_{2i}$、$X_{3i}$三个解释变量,所以分子自由度$k = 3$。
    • 分母自由度$n - k - 1$:其中$n$是样本容量,$k$是解释变量个数。已知样本容量$n = 30$,解释变量个数$k = 3$,则分母自由度为$n - k - 1=30 - 3 - 1 = 26$。
  3. 确定显著性水平:
    题目中给定的显著性水平为$\alpha = 0.05$。
  4. 确定拒绝零假设的条件:
    在F检验中,当F统计量大于给定显著性水平下的临界值时,我们拒绝原假设。对于本题,F统计量服从自由度为$(3,26)$的F分布,显著性水平为$0.05$,所以临界值为$F_{0.05}(3,26)$,即当统计量$F\gt{}F_{0.05}(3,26)$时,拒绝零假设。

相关问题

  • 下列说法正确的是()A. 方差数值上等于各个数据与样本方差之差的平方和之平均数B. 协方差衡量了多个变量的分布C. 协方差和方差的计算方式完全一致D. 方差描述了样本数据的波动程度

  • 下列说法正确的是()A. 方差数值上等于各个数据与样本方差之差的平方和之平均数B. 协方差和方差的计算方式完全一致C. 协方差衡量了多个变量的分布D. 方差描述了样本数据的波动程度

  • 像从性不好的资料是()A. 由于死亡或者其他原因不能继续试验B. 能按照试验规定要求完成实验C. 重复参加试验D. 由于纳入标准不合格导致选择的研究对象不符合试验要求E. 能完成试验但是不能按照规定要求完成试验

  • 可以从最小化每个类簇的方差这一视角来解释K均值聚类的结果,下面对这一视角描述正确的A. 每个样本数据分别归属于与其距离最远的聚类质心所在聚类集合B. 每个簇类的质心累加起来最小C. 最终聚类结果中每个聚类集合中所包含数据呈现出来差异性最大D. 每个簇类的方差累加起来最小

  • 重测信度用重测相关系数来表示,相关系数越趋近于下列哪一数值时,则重测信度越高A. 1B. 0.7C. 2D. 3

  • 2024年,我国每天大约有( )个小包裹往来于中国和世界各国之间A. 800万B. 1100万C. 1000万D. 900万

  • 对研究对象制定明确的纳入标准和排除标准,是为了保证样本的A. 可靠性B. 可行性C. 代表性D. 合理性E. 科学性

  • 下列关于回归分析的描述不正确的是()A. 回归分析模型可分为线性回归模型和非线性回归模型B. 回归分析研究不同变量之间存在的关系()C. 刻画不同变量之间关系的模型统称为线性回归模型D. 回归分析研究单个变量的变化情况

  • {15分)常规情况下,下列不属于人口学变量的是A. 民族B. 收入C. 年龄D. 睡眠时间E. 性别

  • {1.5分)确定研究总体和样本时,不需要考虑A. 立题依据B. 样本量C. 抽样方法D. 目标总体E. 纳入及排除标准

  • 44.2021年,我国人均预期寿命提高到了()。A. 78岁B. 79岁C. 78.2岁D. 79.2岁

  • 请你从下表中找出1~100中所有质数.并数一数一共多少个. 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100

  • 下列哪项属于常见的池化方式。()A. 反向传播B. 最大池化C. 方差池化D. 协方差池化

  • 假定用于分析的数据包含属性age.数据元组[1]中age的值如下(按递增序):13,15,16,16,19,20,20,21,22,22,25,25,25,30,33,33,35,35,36,40,45,46,52,70, 问题:使用按箱平均值平滑方法对上述数据进行平滑,箱的深度为3。第二个箱子值为:A. 18.3B. 22。6C. 26。8D. 27。9

  • 48皮尔逊相关系数的取值范围为0到正无穷。()A. 错误B. 正确

  • 皮尔逊相关系数的取值范围为0到正无穷。()A. 正确B. 错误

  • 下列哪项属于常见的池化方式。()A. 协方差池化B. 方差池化C. 反向传播D. 最大池化

  • 以下几种数据挖掘功能中,〔〕被广泛的用于购物篮分析.A. 关联分析B. 分类和预测C. 聚类分析D. 演变分析

上一页下一页
logo
广州极目未来文化科技有限公司
注册地址:广州市黄埔区揽月路8号135、136、137、138房
关于
  • 隐私政策
  • 服务协议
  • 权限详情
学科
  • 医学
  • 政治学
  • 管理
  • 计算机
  • 教育
  • 数学
联系我们
  • 客服电话: 010-82893100
  • 公司邮箱: daxuesoutijiang@163.com
  • qt

©2023 广州极目未来文化科技有限公司 粤ICP备2023029972号    粤公网安备44011202002296号